Xây dựng chatbot hỏi đáp tài liệu biết khi nào nên nói "Tôi không biết"
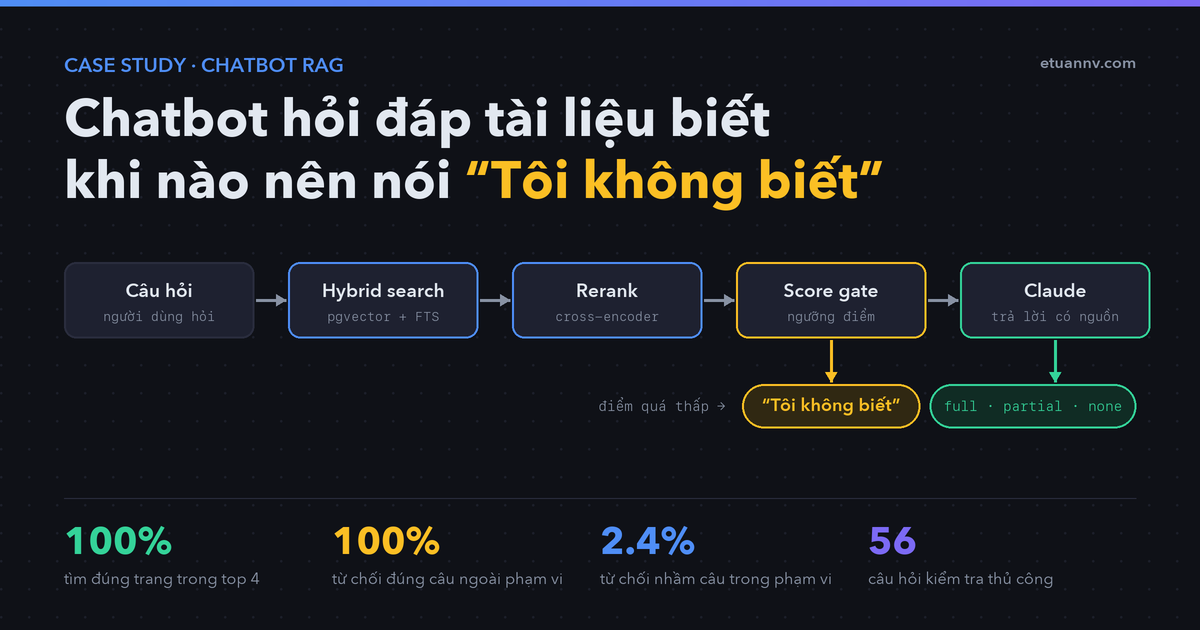
Hầu hết các bản demo RAG đều tập trung vào việc trả lời câu hỏi. Phần khó hơn là biết khi nào không nên trả lời.
Một chatbot hỗ trợ tự tin bịa ra một tham số API còn tệ hơn là không có chatbot. Người dùng có thể làm theo thông tin sai, rồi đội ngũ của bạn phải mất thời gian để xử lý hậu quả.
Vì vậy, khi xây dựng hệ thống hỏi đáp trên tài liệu API của ShipStation, tôi đo hai thứ: hệ thống tìm đúng câu trả lời thường xuyên đến đâu, và nó từ chối trả lời đúng lúc thường xuyên đến đâu.
Đây là kết quả cuối cùng trên bộ benchmark 56 câu hỏi do tôi tự xây dựng và kiểm tra thủ công:
| Chỉ số | Kết quả |
|---|---|
| Tìm đúng trang trong top 4 | 100% (41/41 câu hỏi) |
| Từ chối đúng các câu hỏi ngoài phạm vi | 100% (15/15) |
| Từ chối nhầm câu hỏi nằm trong phạm vi | 2.4% (1/41) |
Vấn đề
Tôi tích hợp ShipStation API cho một khách hàng e-commerce. Tài liệu của họ có hơn 50 trang, bao gồm rate limits, tạo label, khai báo hải quan quốc tế, batch processing và nhiều nội dung khác.
Ngay cả một câu hỏi đơn giản như “điều gì xảy ra khi tôi chạm giới hạn rate limit?” cũng có thể yêu cầu tìm kiếm ở nhiều trang rồi ghép thông tin từ các phần khác nhau.
Một LLM thông thường không phù hợp cho trường hợp này. Nó rất dễ tự tin tạo ra những tên endpoint nghe có vẻ hợp lý nhưng không tồn tại.
Tôi cần câu trả lời dựa trên chính tài liệu, có citation cho từng thông tin quan trọng, và phải từ chối rõ ràng khi tài liệu không đề cập đến vấn đề đó.
Tôi đã xây dựng gì?
Tôi xây dựng một pipeline retrieval-augmented generation tự host:
- Ingestion — 52 trang tài liệu được parse thành 611 chunks. Tôi chia chunk theo heading thay vì theo số lượng token cố định, đồng thời gắn heading breadcrumb vào từng chunk.
- Retrieval — hybrid search kết hợp dense vector similarity (pgvector trên PostgreSQL) với PostgreSQL full-text search, sau đó hợp nhất kết quả bằng Reciprocal Rank Fusion.
- Reranking — cross-encoder sắp xếp lại các candidate tốt nhất và quan trọng hơn là tạo ra một absolute relevance score.
- Generation — Claude chỉ trả lời dựa trên các đoạn tài liệu được retrieve, kèm citation và tự báo mức độ coverage của câu trả lời.
Stack: Python, PostgreSQL + pgvector, OpenAI embeddings, Cohere Rerank, Claude.
Ba lớp chống hallucination
Chỉ dùng một relevance threshold là chưa đủ. Bộ benchmark cho tôi thấy khá rõ điều đó.
Layer 1 — Score gate (code).
Nếu chunk có điểm cao nhất thấp hơn threshold, hệ thống từ chối ngay mà
không gọi model. Model không được gọi thì cũng không có cơ hội tự bịa
câu trả lời.
Cách này bắt được 12 trong 15 câu hỏi ngoài phạm vi với chi phí gần như bằng 0.
Layer 2 — Chunk filter (code).
Ngay cả khi câu hỏi vượt qua score gate, các chunk yếu vẫn bị loại khỏi
context.
Với một câu hỏi, cách này giảm context từ 4 chunks xuống còn 2 mà không làm mất thông tin trong câu trả lời. Ít noise hơn cũng đồng nghĩa với ít cơ hội để model tự liên tưởng sang những thứ không liên quan.
Layer 3 — Model self-assessment.
Cuối mỗi câu trả lời, model trả về một coverage verdict có thể đọc bằng
máy: full, partial, hoặc none.
Layer thứ ba không phải là phần dư thừa. Một ví dụ sẽ cho thấy lý do.
Câu hỏi “How do I enable two-factor authentication for my ShipStation login?” có score 0.746 — cao hơn hầu hết các câu hỏi hợp lệ trong benchmark của tôi.
Lý do là từ “authentication” khớp rất mạnh với trang nói về API authentication. Vì vậy câu hỏi trông có vẻ liên quan dù thực tế không phải.
Không có numeric threshold nào có thể tách câu hỏi này khỏi một câu hỏi hợp lệ. Model phải đọc nội dung thực tế và nhận ra rằng trang đó nói về API keys, không phải 2FA ở cấp tài khoản.
Có thêm hai câu hỏi khác cũng vượt qua gate theo cách tương tự và được model bắt lại.
Tôi đã đo như thế nào?
Tôi xây dựng một golden set gồm 56 câu hỏi và kiểm tra thủ công từng expected answer dựa trên tài liệu:
- 30 câu hỏi “easy” — cách diễn đạt khá gần với wording trong tài liệu.
- 11 câu hỏi “hard” — được viết theo cách người dùng thực tế thường hỏi, mô tả triệu chứng thay vì gọi tên tính năng. Ví dụ: “The API stopped responding after I sent a few hundred requests in a row.” Câu hỏi này không hề nhắc đến rate limits.
- 15 câu hỏi ngoài phạm vi — bao gồm những near-miss được thiết kế để thực sự khó: câu hỏi có chung vocabulary với tài liệu nhưng hỏi về thứ mà tài liệu không đề cập.
Sau đó tôi so sánh bốn cấu hình retrieval trên cùng một bộ dữ liệu, sử dụng recall@4 và Mean Reciprocal Rank.
Kết quả đo lường đã thay đổi cách tôi xây hệ thống
Các câu hỏi easy đã khiến tôi hiểu sai về hệ thống.
Với những câu hỏi có cách diễn đạt giống tài liệu, vector search thuần túy đạt MRR hoàn hảo 1.000. Thậm chí thêm hybrid search còn làm kết quả tệ hơn.
Kết luận ban đầu rất rõ: đơn giản hóa pipeline.
Nhưng các câu hỏi hard lại cho kết quả hoàn toàn khác.
Vector search một mình giảm xuống 0.682. Trang đúng vẫn luôn nằm trong top 4, nhưng thường ở rank 2 hoặc 3 thay vì rank 1.
Hybrid search kết hợp reranking đạt 0.848, tăng +0.167.
Cả hai thành phần đều có lý do để tồn tại. Bộ câu hỏi easy đơn giản là không còn nhiều chỗ để cải thiện, nên nó không thể cho thấy sự khác biệt.
Chunking quan trọng hơn việc chọn model nào.
Chia tài liệu theo cấu trúc thay vì số token cố định, rồi thêm heading breadcrumb vào đầu mỗi chunk, giúp retrieval chính xác hơn một cách đo được. Nó cũng loại bỏ phần hedging trong một câu trả lời trước đó vốn chưa đầy đủ.
Ba “failure” thực ra lại là lỗi trong test set của tôi.
Mỗi khi metric báo có vấn đề, thứ đầu tiên tôi kiểm tra là ground truth chứ không phải hệ thống. Cả ba trường hợp, hệ thống đều đúng và label của tôi mới là sai.
Đây là một lỗi khá dễ mắc khi đánh giá RAG. Nếu ground truth dựa trên những giả định chưa được kiểm chứng, bạn có thể tạo ra những con số trông rất nghiêm túc nhưng thực tế không nói lên nhiều điều.
Giới hạn cần nói rõ: 11 câu hỏi hard vẫn là một sample khá nhỏ.
Chỉ cần một câu hỏi tăng lên một rank là MRR thay đổi khoảng 0.045. Vì vậy khoảng cách lớn (+0.167) khá chắc chắn, còn những bước trung gian vẫn nằm trong phạm vi noise.
Bước cải thiện tiếp theo là mở rộng bộ câu hỏi hard.
Điều này có ý nghĩa gì với dự án của bạn?
Cách tiếp cận này có thể áp dụng cho gần như mọi bộ tài liệu — API docs, chính sách nội bộ, product manuals hoặc support knowledge base.
Điều khiến nó trở thành một hệ thống production-ready thay vì chỉ là một bản demo:
- Mỗi câu trả lời đều có citation quay về source.
- Hệ thống từ chối thay vì đoán, và refusal rate được đo lường.
- Threshold được calibration dựa trên chính corpus của bạn, thay vì copy từ một tutorial.
- Benchmark đi cùng hệ thống, vì vậy có thể đo lại chất lượng sau mỗi thay đổi.
Nếu bạn đang đánh giá một documentation assistant, câu hỏi không chỉ là “nó có trả lời được không?”
Mà là “điều gì xảy ra khi câu trả lời không có trong tài liệu?”
Và quan trọng hơn, có ai đưa cho bạn được con số đó không?
Xem thêm:
- Cách tôi xây dựng một MCP server chỉ đọc để kết nối ứng dụng Django với Claude — một tích hợp production khác đưa Claude vào làm việc trên dữ liệu kinh doanh thực tế
- AI Phân loại Email: Từ Inbox đến Hành động trong Dưới 60 giây — Claude phân loại và điều phối email thực tế
- Prompt Engineering Qua 5 Cấp Độ: Từ Prompt Đồ Chơi Đến Pipeline Chạy Thật — cách viết prompt có cấu trúc, bám sát nguồn như pipeline này cần
Xây dựng trên tài liệu API công khai của ShipStation như một bản triển khai tham khảo. Không liên kết hay được ShipStation bảo trợ.